MSA测量系统分析:从概念到实战的研发技术指南
研发技术人员的日常里,多半遇到过这几个场景:同一块材料,两个人测出来的数据对不上;DOE 做完,主效应和误差项混在一起分不出高低;来料检验判定合格,产线用起来却频频出问题。这些问题的共同源头,往往不是材料、不是工艺,而是你手里那把「尺子」本身。
MSA(Measurement System Analysis,测量系统分析)就是系统性地审视这把尺子的方法。它不是质量部门的专属报表游戏——对研发而言,测量系统的能力决定了你所有试验数据的信噪比下限。这篇文章把概念、算法、判定标准和研发实战一次讲透。
一、先把概念立住:测量值 = 真实值 + 变差
你读到的每一个数据,都不是被测对象的真实值,而是真实值叠加了一堆变差之后的观测值。这堆变差里,一部分来自被测对象本身(零件间差异、材料不均匀性),另一部分来自测量系统。MSA 要做的事,就是把后者定量地拆解出来。
测量系统的特性,行业里习惯概括为「五性」:
| 特性 | 回答的问题 | 一句话判断 |
|---|---|---|
| 分辨力(Resolution) | 尺子刻度够不够细 | 至少能读到公差的 1/10 |
| 偏倚(Bias) | 测得准不准 | 同一标准件反复测,均值偏离基准值多少 |
| 线性(Linearity) | 量程内偏倚是否一致 | 小尺寸准、大尺寸不准,就是线性差 |
| 稳定性(Stability) | 随时间漂不漂 | 同一标准件隔周测,均值是否守住 |
| 重复性 & 再现性(GR&R) | 测得稳不稳 | 同人同件反复测的散布 + 换人的偏移 |
其中前四性是「准不准」的问题,GR&R 是「稳不稳」的问题——这个区分贯穿全文,也是绝大多数误用的起点。
偏倚和线性最容易被忽略,因为它们藏在 GR&R 报告之外。做法其实不复杂:取 5 个覆盖量程的标准件(或用更高等级仪器定值),每件重复测量取均值,均值减去基准值就是偏倚;把各点的偏倚对基准值作图,拟合线如果不水平、不贴零,说明偏倚随量程变化:
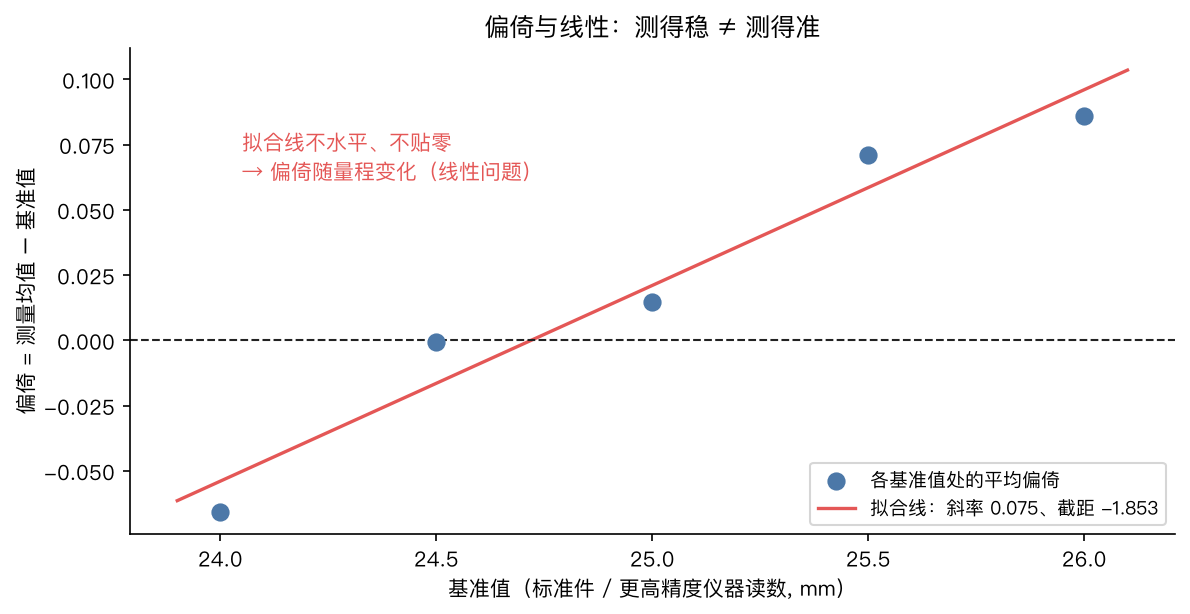
一台千分尺在 25 mm 附近偏倚 +0.02,到 26 mm 偏到 +0.10——每批货测得都很「稳定」,但每一个数都系统性偏大。这种问题 GR&R 再漂亮也查不出来。
二、GR&R:把测量误差定量拆开
GR&R(Gage Repeatability & Reproducibility)是 MSA 的核心工具,它只拆两个成分:
- 重复性(EV,Equipment Variation):同一个人、同一台设备、同一个零件,连续反复测,读数散布多大——反映设备本身
- 再现性(AV,Appraiser Variation):换一个人测,整体偏移多大——反映人之间的差异
看一张实际数据就明白了。取同一个零件,三名操作员每人盲测 3 次:
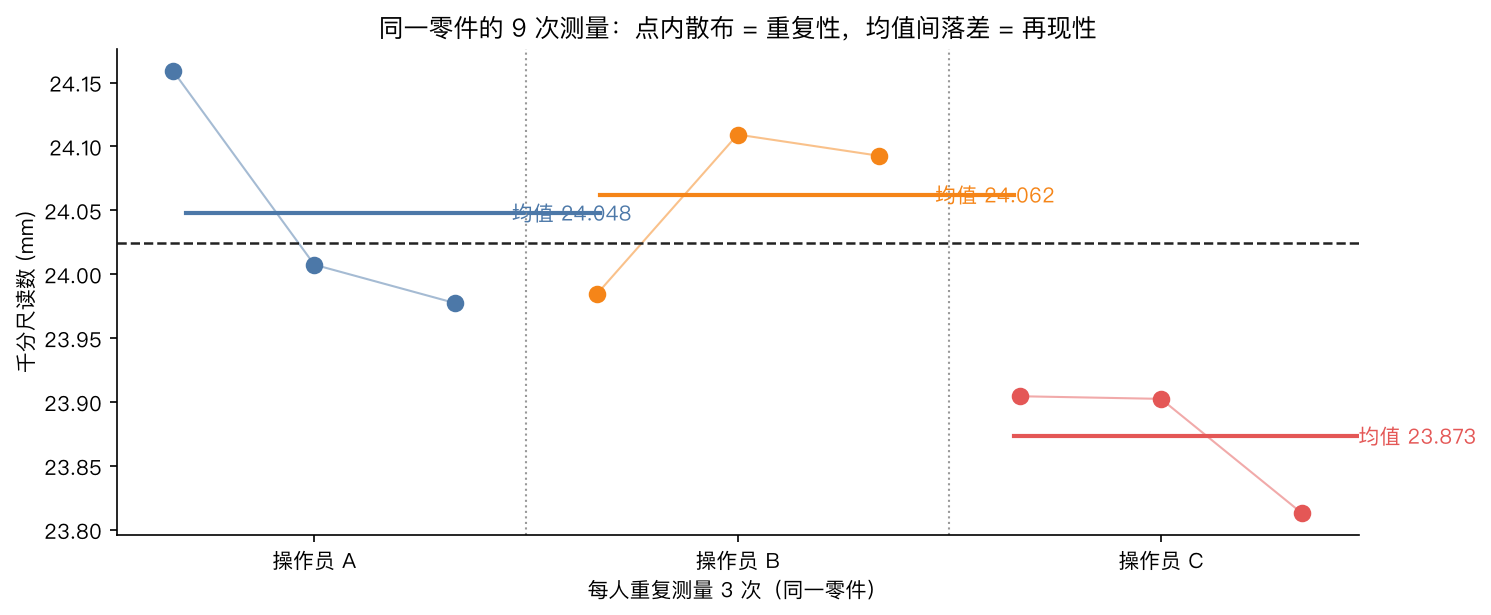
每个人 3 个点散开的幅度,就是重复性;A、B、C 三段均值之间的落差,就是再现性。这张图还有个实用诊断:如果重复性占大头,去查设备(夹持力、温漂、维护状态);如果再现性占大头,去查人的因素(读数习惯、操作 SOP、培训)。
标准做法:交叉法 10×3×3
经典的可重复测量 GR&R(交叉法,Crossed GR&R)流程:
- 选 10 个零件,覆盖生产过程的真实波动——注意,是「过程波动」,不是整个公差范围,后面会讲为什么
- 3 名操作员,每人每个零件盲测 3 次(顺序随机、互相看不到读数),共 90 个数据
- 用均值极差法或**方差分析(ANOVA)**计算方差成分
- 输出判定指标和图形报告
均值极差法用控制图的统计逻辑估算各成分(重复性 = 平均极差/d₂,零件间 = 零件均值的极差/d₂*),手算表格就能做;ANOVA 则多拆出一项「操作员×零件交互作用」——某个操作员测软材料偏偏读数偏低,这种交互只有 ANOVA 能看见。有软件条件就用 ANOVA,它是均值极差法的严格上位替代。
一个贯穿全文的实战案例
为了让数字不是纸上谈兵,构造一个典型研发场景:铝合金压铸件壁厚测量,千分尺,规格 25±1.0 mm,按 10×3×3 做交叉 GR&R,计算结果:
| 指标 | 数值 | AIAG 判定 |
|---|---|---|
| %StudyVar(GRR 占总变差) | 29.4%(EV 14.1% + AV 25.8%) | 10~30%:有条件接受 |
| %Contribution(方差占比) | 8.7%(EV 2.0% + AV 6.7%) | 1~9%:有条件接受 |
| %Tolerance(GRR 占公差) | 43.1% | >30%:不可接受 |
| ndc(可区分类别数) | 4 | <5:不足 |
| 再现性 : 重复性 | 25.8% : 14.1% | 人的差异是主要矛盾 |
同一套数据,四个指标给出四种脸色——这不是矛盾,而是它们各自回答不同的问题。把这件事想通,MSA 就算入门了。
三、读懂图形报告:极差图与均值图
数字之外,GR&R 的两张控制图包含大量信息,多数人只看表格不看图,很可惜。
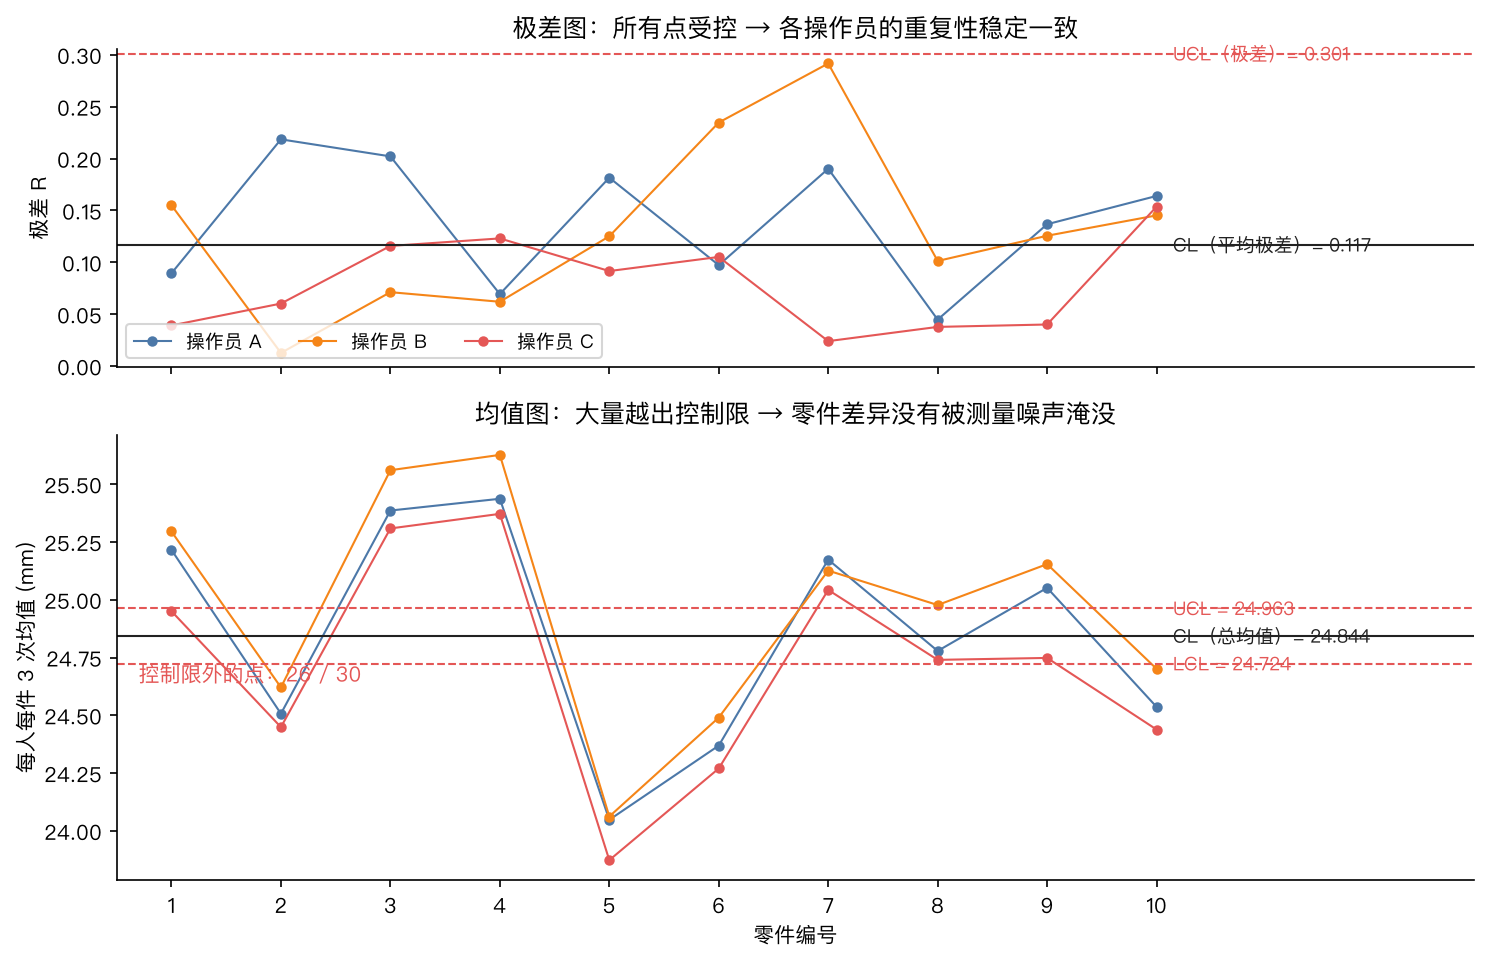
极差图(上):把每个操作员×每个零件的 3 次读数求极差画出来。所有点受控,说明每人的测量动作稳定一致;如果某人的点系统性偏高,他的操作方式有问题;如果某个零件的极差异常大,可能是零件本身有毛刺、装夹不稳。
均值图(下):把每人每件的均值画出来,叠加按重复性算出的控制限。这张图的关键读法是控制限外的点数:控制限宽度反映测量噪声,点的散布反映零件差异。越出控制限的点越多,说明零件间信号相对测量噪声越显著,测量系统越有区分能力。如果所有点都缩在控制限内排成一条横线,意味着零件差异完全被测量噪声淹没——这把尺子测不出零件的不同。
本案例 30 个均值点有 26 个越出控制限,区分能力尚可,这与前面判定表给出的信号一致。
四、判定标准:为什么四张成绩单会打架
看两个口径的分解图,直观感受一下「同一系统、两种算法」:
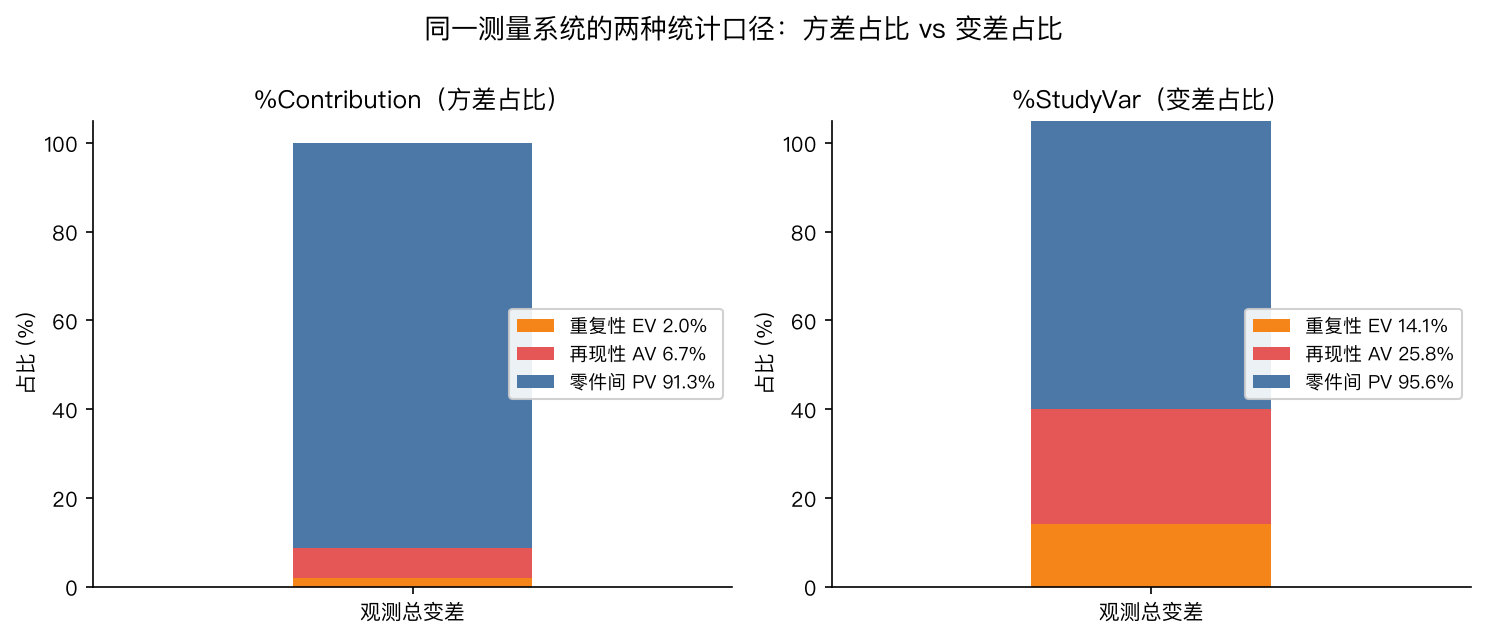
同样的方差成分,%Contribution 用方差(σ²)占比,%StudyVar 用标准差(σ)占比,数字上差一个平方关系:8.7% 的方差占比对应 29.4% 的变差占比。所以 AIAG 给两套口径各配了阈值——%Contribution 的 1% / 9% 对应 %StudyVar 的 10% / 30%,本质上是一回事。
真正的分歧在分母。三个常用口径回答三个不同问题:
| 口径 | 分母 | 回答的问题 | 适用场景 |
|---|---|---|---|
| %StudyVar | 总观测变差 6σ | 能否区分这批样品的差异 | 过程研究、DOE 前的能力确认 |
| %Tolerance | 公差带 | 判合格/不合格会不会判错 | 分选检验、出货判定 |
| ndc | GRR 本身 | 能把产品分成几档 | 分级、排序 |
本案例是最好的注解:%StudyVar 29.4% 勉强及格,说明「研究过程变差」还凑合;%Tolerance 43.1% 严重超标,说明拿这把千分尺做 25±1.0 的合格判定,误判风险不可接受——公差带 2.0 mm,而测量噪声 6σ 就有 0.86 mm,吃掉了公差的四成多。
选口径的原则:看这把尺子拿来干什么。 用于研发测量和过程监控,看 %StudyVar 和 ndc;用于出货判定和分选,%Tolerance 一票否决。案例中的正确结论是:这把千分尺可以用于过程研究,但必须升级(换数显千分尺、固定测量点位、加治具)才能承担合格判定职责。
还有一个隐含的分母陷阱:%StudyVar 的分母取决于你选的 10 个零件。选样时如果刻意挑差异大的零件(混批次、跨规格),分母被撑大,%GR&R 虚低,系统「假装合格」;反之挑 10 个几乎一样的零件,%GR&R 虚高。所以选样必须代表过程的真实波动,并且要在报告中注明样品来源。
五、Wheeler 的补充视角:EMP 与监视器等级
到这里都是 AIAG(汽车工业行动集团,MSA 参考手册第四版)的框架。但学术界对它的判定阈值一直有批评,代表人物是统计学家 Donald Wheeler。他的 EMP(Evaluating the Measurement Process)方法主张用组内相关系数 ICC 评价测量系统:σ零件² / σ总²,即观测变差中有多少比例是真实的产品信号。
按 ICC 把测量系统分成四个等级,并与 AIAG 的判定对照:
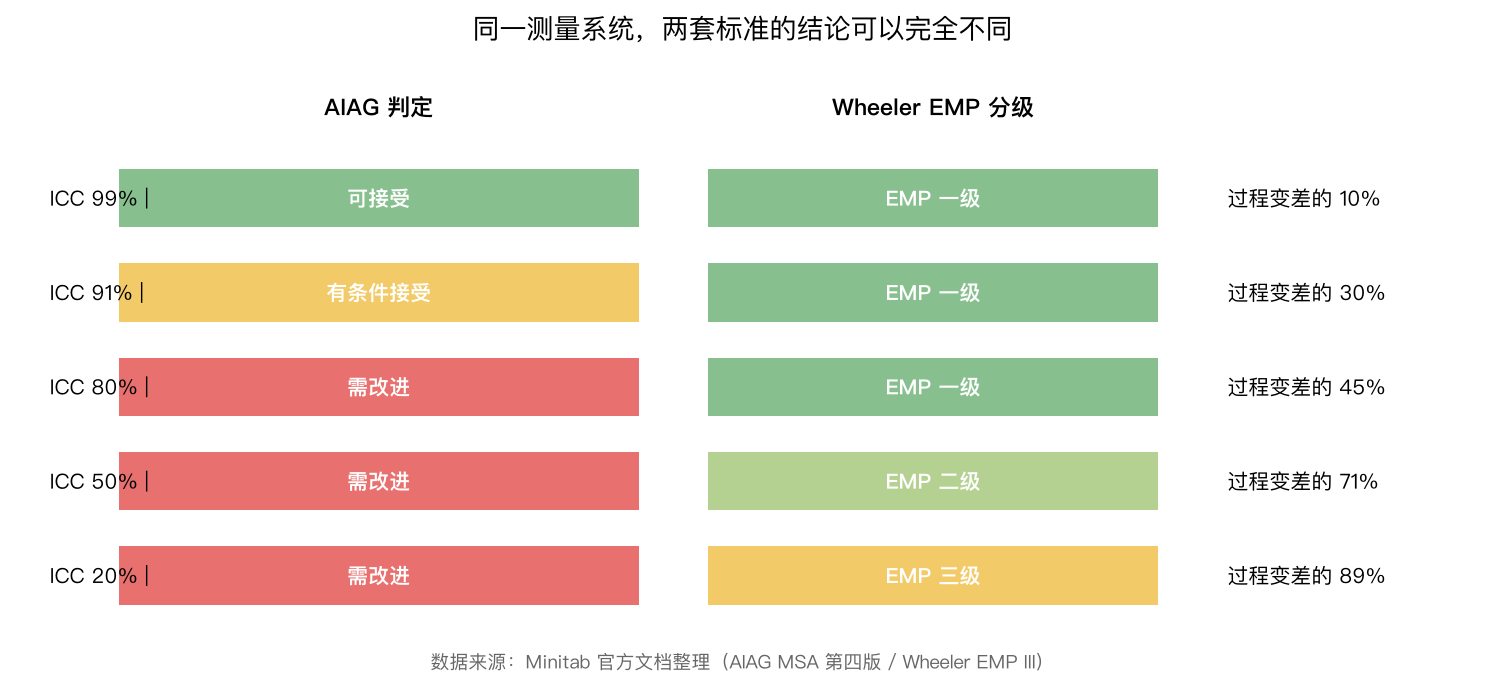
两套标准给出完全不同的结论:AIAG 认为 %StudyVar 30% 只是「有条件接受」的系统,在 EMP 框架里 ICC 高达 91%,是能可靠监测过程均值偏移的一级监视器;AIAG 判「需改进」的 45% 系统,EMP 仍评一级。本案例 ICC = 0.913,恰好落在第二行。
分歧的根源在于两套标准的出身:AIAG 来自汽车工业,传统上关注紧公差下的分选判定,对测量精度要求苛刻;EMP 出自过程改进传统,关心的是控制图上能否及时发现均值偏移——一级监视器在 3σ 偏移发生时,用少量子组就能以接近 1 的概率报警。用途不同,宽严自然不同。
工程上的务实态度:两套都懂,按用途取用。做产品判定,老老实实按 AIAG 的 %Tolerance;做过程监控和研发测量,EMP 的视角更合理,也解释了为什么很多「不合格」的测量系统在控制图上用得很好。
六、研发场景的三个实战应用
场景一:DOE 之前先做 MSA
这是研发人员最该建立的习惯。DOE 的本质是从噪声里提取信号:重复测量误差会直接进入残差项,抬高效应检验的噪声地板。如果测量系统 %GRR 在 50%,而 DOE 因素的主效应只占总变差 30%,效应检验注定不显著——你会误判「这个因素不重要」,然后做出错误的工艺窗口决策。
正确顺序:先对响应量的测量手段做 GR&R → 确认 %GRR 和 ndc 达标 → 再设计试验。测量噪声大时,应对办法只有两个:升级测量手段,或按误差传递计算加大每组的重复数——后者意味着样品和工时翻倍,晚算不如早算。
场景二:破坏性试验用嵌套法
拉伸、冲击、硬度这类测完即报废的项目,无法对同一件样品重复测量,交叉法从根上不适用。嵌套法(Nested GR&R)的思路是:把「同一批次、同一条件下制备的多个样品」视为「同一个零件」的化身,每人测量这组样品中的一份。
要害在于制样的同质性——嵌套法的重复性估计里混入了制样散差,这是方法固有的局限,报告里必须写明「该 GR&R 含制样变差」。实操建议:制样时固定机台、模穴、工艺参数,把制样变差压到最小,否则测出来的「测量系统不合格」其实是制样不稳定。
场景三:实验室间数据比对
研发经常遇到本厂实验室和供应商、第三方实验室数据对不上的纠纷。单次对比说不清谁对谁错,正确的做法是一次小型 GR&R 变体:把同一批留样(嵌套法意义上的「同件」)分发各实验室,按同一 SOP 各测若干次,用再现性成分量化「实验室间差异」。如果实验室间差异显著大于实验室内重复性,问题就不在材料,而在两家测量系统的某个环节——设备、夹具、方法、环境四选一,逐项排查。
七、常见坑清单
- GR&R 合格 ≠ 测量系统合格:五性只测了两性,偏倚/线性/稳定性要靠校准和定期标准件核查补齐
- 分辨率不足:设备读数精度应至少到公差的 1/10,ndc 偏低先查这里
- 选样骗局:%StudyVar 的分母随选样变化,样品必须代表过程真实波动
- 盲测缺失:操作员知道彼此读数会互相「校准」,再现性被系统性低估
- 稳定地错:所有指标都好,但偏倚为常数——每个数据都错同一个数,只有标准件核查能暴露
- 报告只贴表格:不看极差图和均值图,丢掉了诊断设备/人/零件问题的最好线索
八、落地路线图
给研发团队的 MSA 最小可行方案:
- 建台账:列出所有用于判定和研发数据采集的测量手段,标出各自承担的判定职责
- 按职责分级:承担合格判定的量具,%Tolerance 必须达标;仅用于过程研究/监控的,以 %StudyVar + ndc 为准
- 新量具投产前:做完整五性分析(偏倚、线性、稳定性、GR&R),存档基线
- 周期性维护:校准时补偏倚验证,关键特性定期用标准件做稳定性核查,留存控制图
- 重大试验前:DOE 和能力验证的响应量,先跑一次快速 GR&R(哪怕 5×2×2 的简化版)确认测量能力
最后一个判断值得写进研发流程的注释里:数据是决策的地基,MSA 是验收地基的那一步。地基检查的成本永远低于房子倾斜之后的返工——无论房子是一批货,还是一个工艺窗口的结论。
参考资料
- AIAG, Measurement Systems Analysis Reference Manual, 4th Edition, 2010
- Donald J. Wheeler, EMP III: Evaluating the Measurement Process & Using Imperfect Data, SPC Press
- Minitab 官方文档:Gage R&R 与 Wheeler’s EMP 判定标准